
 由 Sarah Xiao
多数人学机器人算法的方式,是按课程表的顺序:先数学,再运动学,再控制,再感知,最后是”具身智能”。这个顺序讲得通,但用起来几乎全错——因为这个领域不是一串课程,而是一叠不断互相回指的层。
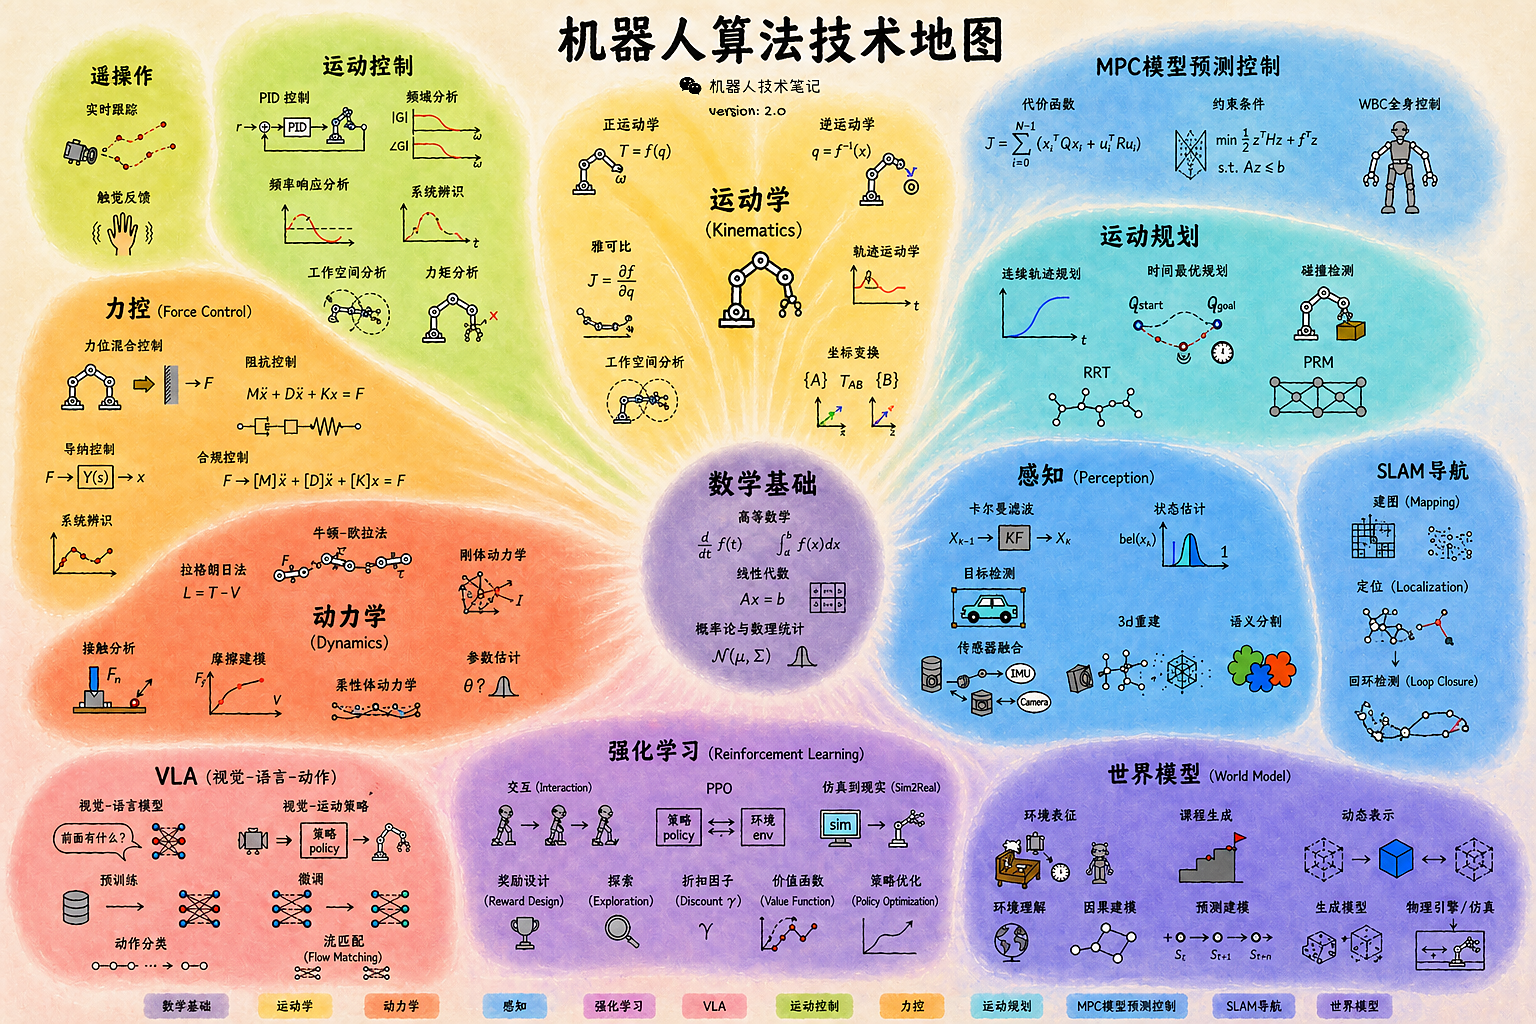
下面这张在中文与英文机器人圈子里流传的知识地图,把结构摊开给人看:数学在正中心,不是因为它是第一门要学的课,而是因为其他每一支都要回头用到它。四周是运动学与动力学、控制与规划、感知与 SLAM,再外面是新的分支——强化学习、VLA、世界模型。
下面按”工程栈”的方式重读这张图:每一层到底在回答什么问题,层与层之间在哪里断掉,以及为什么按顺序学完的人,往往能推导雅可比,却调不好一个抖动的关节。
数学是底座,不是入学考试
高等数学、线性代数、概率论。机器人里的每一个问题,最后都是这三样东西换了一身衣服。
坐标变换是矩阵乘法。一个位姿是齐次变换,一条关节链是变换的连乘,而把顺序写错是机器人代码里最常见的 bug。运动学建模是求导:雅可比就是位置对关节角的导数,J = ∂f/∂q。状态估计是概率:卡尔曼滤波是给定新证据后的高斯条件分布,粒子滤波是同样的事情去掉高斯假设。优化控制是带约束的代价函数,在一个时间窗口上最小化。
这一层之所以在中心而不是在底部,是因为干活的人每天都在回来。规划器给出的轨迹控制器跟不上,问题通常不在规划器:一个变换里的单位错了,一个符号约定反了,或者一个协方差从来没更新过。
运动学与动力学:怎么动,以及为什么动起来会反抗
运动学回答”末端在哪、动得多快”。正运动学是把变换连乘;逆运动学是在给定位姿下反解关节角,冗余和奇异点都从这里冒出来。雅可比把关节速度映射到末端速度,v = J(q) q̇;它的转置把末端力映射回关节力矩,τ = Jᵀ F。到奇异位形时雅可比降秩:某个方向上无论关节转多快末端都动不了,而接近奇异点时关节速度会飙起来。每台六轴机械臂都有这些位形,量产产线要么在布局上绕开,要么在软件里处理。
动力学回答”为什么会这样动”,标准形式是
M(q) q̈ + C(q, q̇) q̇ + g(q) = τ
惯量项、科氏与离心项、重力项。仿真与实机的裂缝就开在这里:在刚体仿真里看起来顺滑的轨迹,到真机上会出现滞后、超调和颤振,因为真机有随方向与温度变化的摩擦,有减速器的柔顺与背隙,有电流和散热都有限的执行器。
工程上的推论是:仿真里调好的控制器只是起点,不是结果。系统辨识——在真实硬件上测摩擦、惯量和延迟——才是把裂缝补上的动作,而它通常是项目里最不体面、也最值钱的那部分工作。
控制与规划:两个经常被混为一谈的问题
控制问”怎么把这条轨迹守住”,规划问”该走哪条轨迹”。
控制是级联结构:电流环在最内,通常几十千赫兹;速度环其次,一到两千赫兹;位置环最外,约一千赫兹。每一环都假设内环足够快、可以当成理想环节,这就是为什么内环慢的关节,外面怎么调都救不回来。PID 仍是主力——u = Kp e + Ki ∫e dt + Kd de/dt——而这个领域大量的实践经验,讲的是三项互相打架时会发生什么:堵转时的积分饱和、编码器噪声被微分项放大、机械臂构型变化时需要增益调度。
频域分析是把调参从手艺变成流程的东西。闭环响应的伯德图给出带宽和相位裕度;柔性关节的谐振在图上是一个峰值,靠加增益永远压不下去;系统辨识给出被控对象模型,没有模型,超出 PID 的设计都无从谈起。
规划要拆成两个问题,它们在闲聊里常常被合并,在代码里从来不该合并。路径规划是几何问题:RRT 和 PRM 在构型空间里采样,返回一条无碰撞路径,两者都不知道也不关心时间。轨迹规划负责分配时间:速度、加速度、加加速度限制,段与段之间的过渡。模型预测控制则再上一层,在滚动窗口里反复求解带约束的优化,
min Σ cost(xₖ, uₖ) 约束 xₖ₊₁ = f(xₖ, uₖ)
它的能力上限,正好等于里面那个模型的准确度。模型错了,MPC 会非常自信地给出错误的动作。
感知与 SLAM:决定前面那些能不能用的那一层
一个知道自己怎么动、但不知道自己在哪的机器人,会直接走进墙里。
感知把传感器数据变成状态:检测、分割、三维重建、多传感器融合。难的部分通常不是模型,而是时间同步、标定,以及相机和激光雷达对”世界在哪”各差几厘米这件事。SLAM 在上面加建图、定位和回环检测;回环检测的作用,是让机器人重新经过同一地点时,漂移不会无限累积。
地图把感知画成和控制的同级模块,而不是预处理步骤,原因就在这里:没有可靠的定位,世界上最好的控制器也只是在错误的坐标系里执行一条轨迹。
强化学习、VLA、世界模型:改写了岗位说明的分支
强化学习把控制重新表述成策略搜索。不设计控制器,而是定义奖励,让策略在交互中变好——PPO、价值函数、探索,然后是 Sim2Real 问题:在仿真里练出来的策略,会去利用仿真搞错的地方。
VLA 换了一个接口:图像加一句自然语言进去,出来是一段动作。它的吸引力在于任务描述不再是手写的状态机;它的问题和所有学出来的模型一样——失败工况没法提前穷举。
世界模型再往前一步,把动力学本身学出来,再用这个学到的模型做预测,或者在里面训练策略。这是过去一年里效率结果最惊人的一支,也是限定条件最要紧的一支:学出来的模型,只在它有数据的地方成立。
这些都不替代前面几层。VLA 输出的动作仍然要由关节控制器去跟踪;强化学习策略仍然跑在有背隙的硬件上;世界模型仍然需要一个状态估计器告诉它机器人在哪。
为什么”按顺序学”会失败
按阶梯教出来的结果是可以预测的:有人能写出 MPC 求解器,却解释不了机器人为什么在某个频率上振动;有人能在仿真里训出策略,却查不出真机上为什么会倒。
按地图来学,问题的顺序就对了。对任何一个新的机器人行为,有用的提问顺序是:
- 我需要知道哪些状态,这些状态测得到吗?(感知、估计)
- 什么运动能产生这个行为,它可达吗?(运动学、规划)
- 需要多大力矩,硬件给得出吗?(动力学、执行器边界)
- 怎么在扰动下守住它?(控制)
- 到此之后才问:学习能不能比基于模型的版本做得更好?
很多在第 5 步失败的项目,其实是在第 1 步或第 3 步就失败了,只是把账记在了算法头上。
地图上没有画出来的三件事
实时性。 算法通常被当作算力免费来教。机器人上,控制回路错过截止时间不是”变慢”,而是”不稳定”。确定性调度、抖动预算、最坏执行时间,应该和控制器设计放在同一场讨论里。
安全。 力矩上限、速度上限、工作空间限制、急停,以及”停下来”和”突然动起来”这两种故障的区别。图上没有这一块,但它决定机器人能不能出厂。
集成。 标定、时间同步、消息延迟、坐标系约定、日志回放。机器人项目比算法工作量所暗示的更慢,原因几乎都在这里。
一句话收尾
这张地图是对的,它最有用的地方在于:上面没有任何一块是可选的。数学不是一次性通过的关卡,而是下游出问题时你要回去的那一层。运动学与动力学说明什么是可能的,控制与规划让它可重复,感知与 SLAM 让它在真实地点成立,学习类分支拓展了能被指定的行为范围。
先把地图看全,再往你项目真正待着的那块深耕。真正能把机器人做出来的人,不是把阶梯走完的人,而是知道哪一层正在骗自己的那个人。